
【指定管理者・PFI事業者向け】機械学習・深層学習とは?AIが「もっともらしい間違い」をする理由がわかる超入門
機械学習・深層学習とは何かを、指定管理者・PFI事業者向けに数式ゼロで解説。AIは調べて答える機械ではなく、膨大な例からパターンを学んで答えを組み立てる機械です。ベテラン受付スタッフのOJT例えで、3つの学び方から深層学習、生成AIと検索機能の役割分担まで一気に理解。文章として自然でも事実とは限らない——原典確認や数字の創作禁止など、AI活用ルールの「なぜ」が腑に落ちる、連載初の仕組み編です。
公開日2026/09/23
目次
指定管理者制度AI編集長のヤマザキです。
どこの施設にも、こういうベテランがいませんか。
受付歴15年の田中さん(仮名)。
常連の佐藤さんが入口に現れた瞬間、顔を見ただけで「今日は卓球場の予約変更だな」と分かる。
新人が驚いて聞きました。
「なんで分かるんですか? マニュアルに書いてあるんですか?」
田中さんは笑って答えます。
「書いてないよ。何百回も見てきたから、なんとなく分かるの」
——実は、いま話題のAIにも、これとよく似た考え方があります。
「こういうときは、こうだ」というルールを人間が全部書き込むのではなく、たくさんの例からパターンを学ぶ。
これが、機械学習の基本的な考え方です。
第7回の今回は、連載初の「仕組み編」です。
これまで6回にわたって、AIの実践的な使い方をお伝えしてきました。 その中で、私は何度も同じ注意を繰り返してきました。
「AIはもっともらしい間違いを混ぜてくる」 「数字を創作させない」 「根拠は原典で確認する」
今日は、そのなぜの話をします。
AIの中身——機械学習と深層学習——の仕組みをざっくり知ると、これまでのルールが全部、「なるほど、だからか」とつながります。
数式は一切出てきません。 出てくるのは、田中さんです。
この記事でわかること
- 機械学習とは何か(マニュアル方式と「田中さん方式」の違い)
- AIの3つの学び方(答え合わせ付き・自分で気づく・試行錯誤)
- 深層学習と「層」の意味——なぜ近年AIが急に賢くなったのか
- 生成AIと「検索」の違い——AIには2つの顔がある
- AIが「もっともらしい間違い」をする仕組み上の理由(流暢さ≠正しさ)
- 仕組みを知ると腑に落ちる、第1〜6回のルールの「なぜ」
- 施設の記録が、AI時代の「知識資産」になる話
結論:AIは「調べて答える機械」ではなく「例から学んだ機械」
いきなり結論です。
多くの人は、AIをこう思っています。
「巨大な百科事典を持っていて、質問されるとそこから調べて答える機械」
実態は、こちらに近い。
「膨大な例を見てパターンを掴み、質問されるとパターンからそれらしい答えを組み立てる機械」
調べているのではなく、組み立てている。
この一点を押さえるだけで、AIの得意・不得意、そしてこの連載でお伝えしてきた注意事項のすべてに、理由が通ります。
では、AIはどうやって「パターンを掴む」のか。 順番に見ていきましょう。
機械学習とは——マニュアル方式と「田中さん方式」
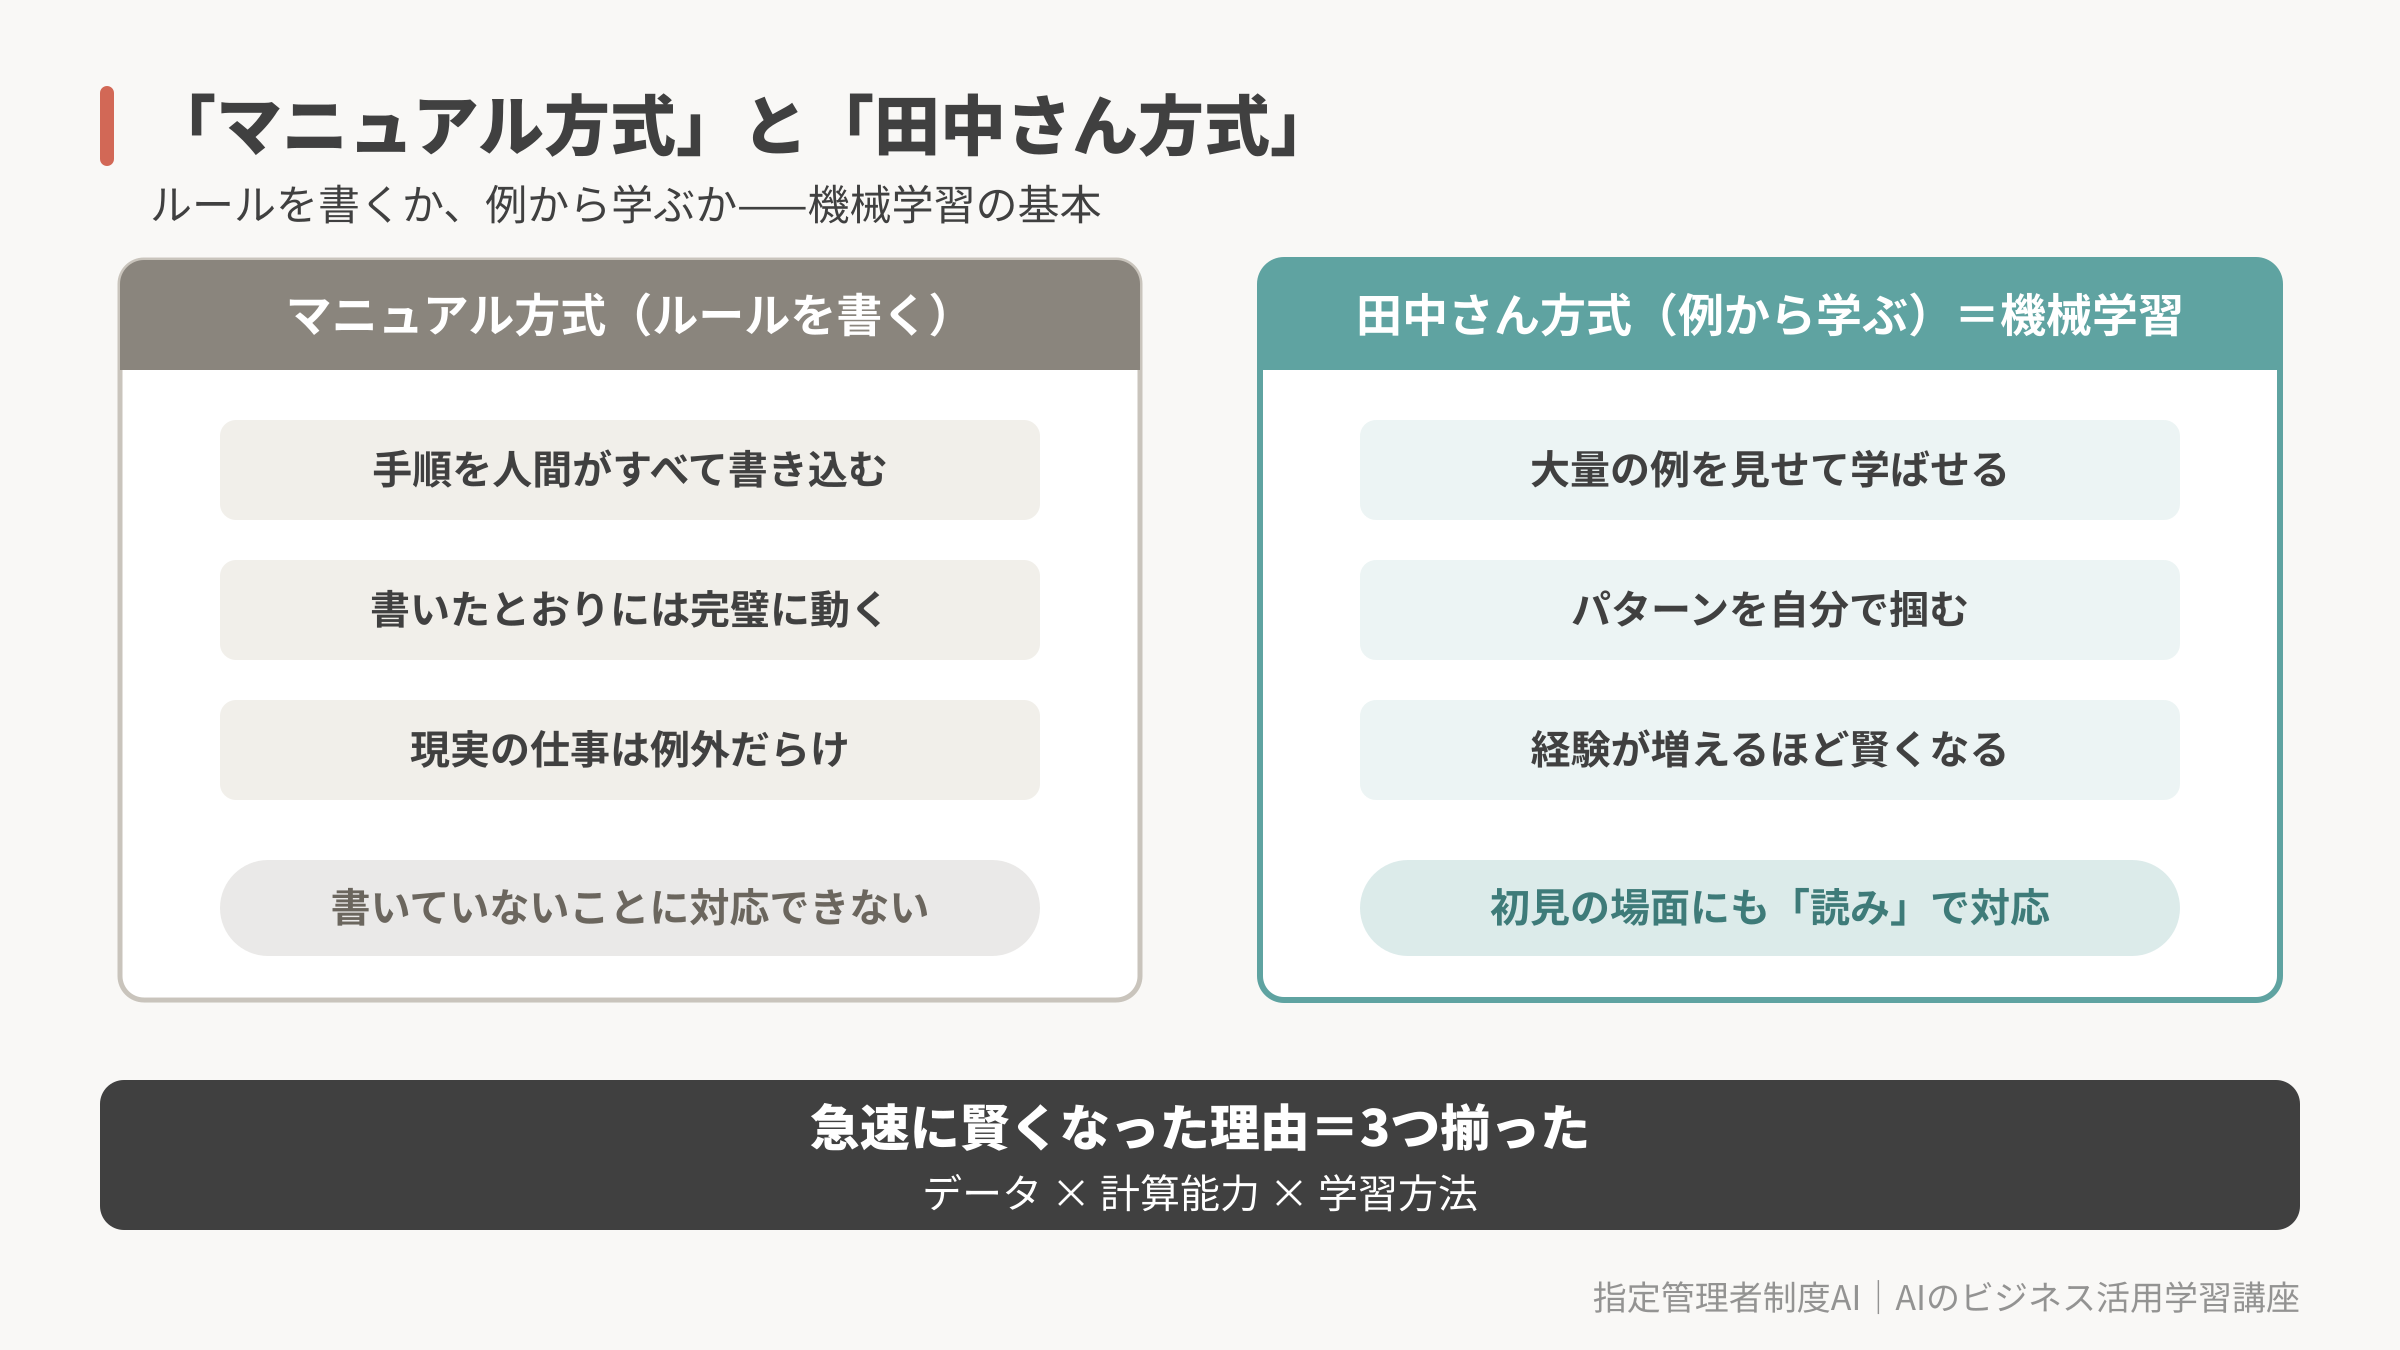
コンピュータに仕事を教える方法は、大きく2つあります。
① マニュアル方式(ルールを書く)
「予約変更の申し出があったら、画面Aを開き、日付を確認し……」と、人間が手順をすべて書き込む方法です。
昔のコンピュータは、基本的にこれでした。 書いたとおりには完璧に動きますが、書いていないことには一切対応できません。
窓口業務を全部マニュアル化しようとしたら、何万ページあっても足りませんよね。 現実の仕事は、例外だらけだからです。
② 田中さん方式(例から学ぶ)=機械学習
手順を書き込む代わりに、大量の例を見せて、パターンを自分で掴ませる方法です。
田中さんが15年分の接客経験から「この顔・この時間帯・この曜日なら、たぶんこの用件」と読めるようになったのと、よく似た考え方。
これが機械学習です。
考え方自体は半世紀以上前からありました。 では、なぜ最近になってAIが急速に賢くなったのか。
大きく言えば、3つが揃ったからです。
① 学ぶためのデータが爆発的に増えた ② 計算能力(GPUなど)が飛躍的に上がった ③ 学習方法やAIの設計そのものが進歩した
つまり、「大量の経験を、ものすごい速さで、上手に学べる環境」が整った。
田中さんが15年かけて積んだ経験を、ケタ違いの規模と速度で学べるようになったわけです。
AIの3つの学び方——現場のOJTにそっくりです
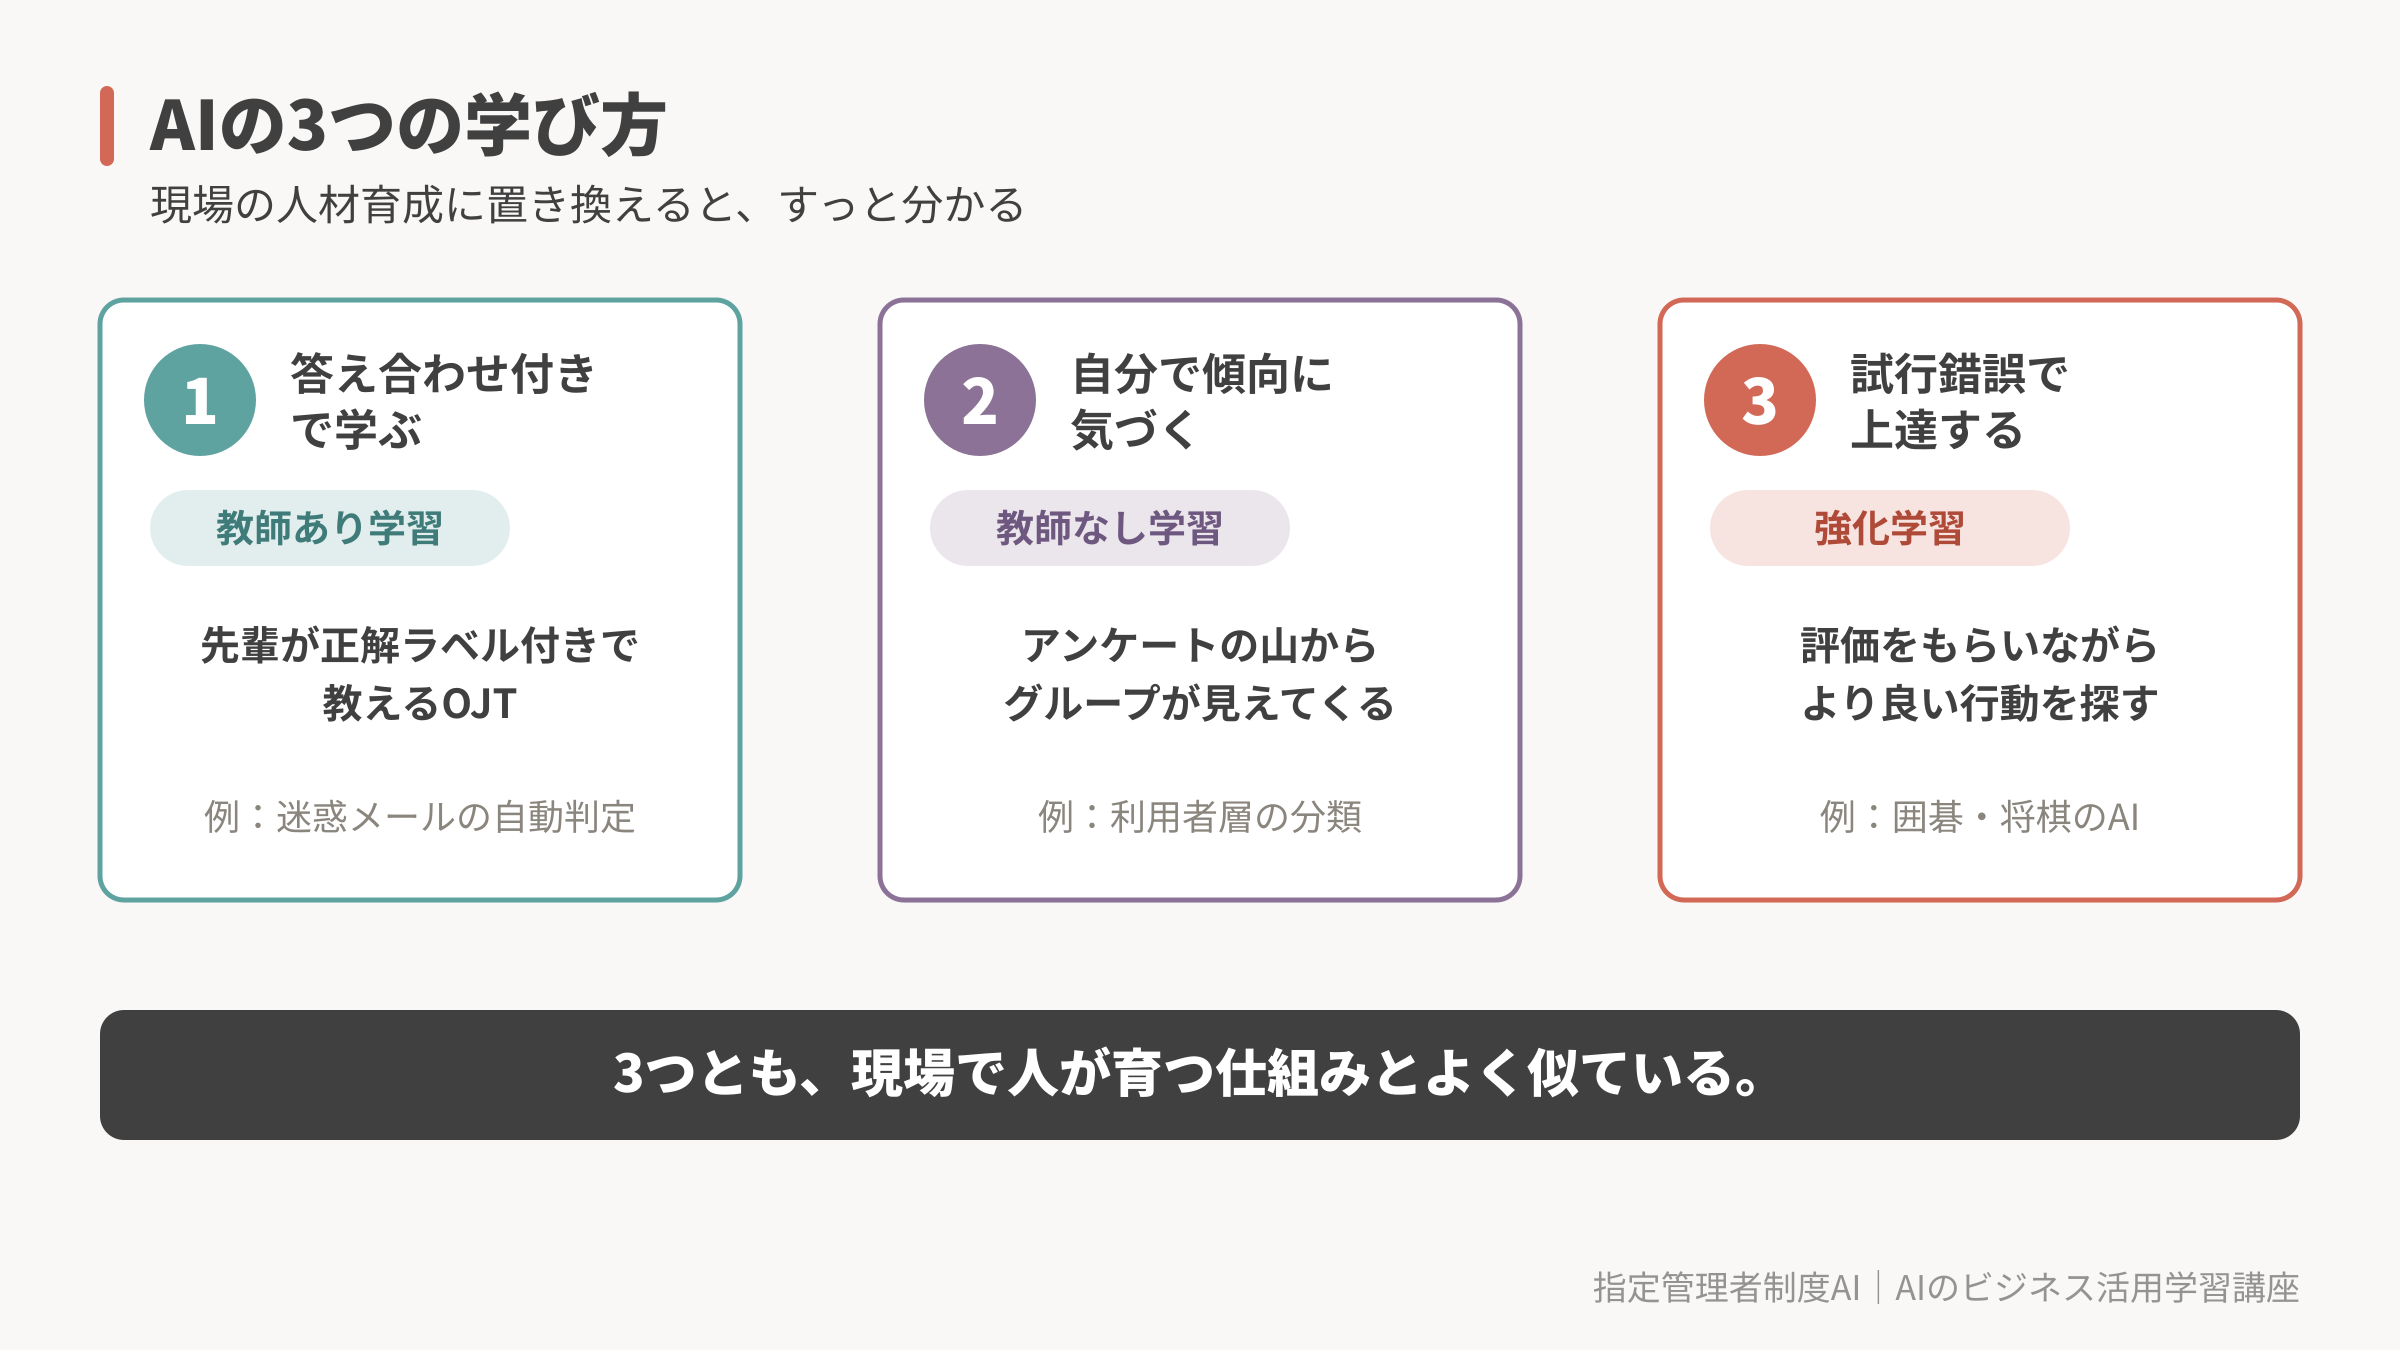
機械学習の「学ばせ方」には、代表的な型が3つあります。 施設の人材育成に置き換えると、すっと分かります。
① 答え合わせ付きで学ぶ(教師あり学習)
新人に過去の問い合わせ記録を見せながら、先輩が横で「これはクレーム対応の事例」「これは通常の予約変更」と正解ラベルを付けて教えていく方式です。
正解付きの例をたくさん見た新人は、やがて初見の問い合わせも正しく仕分けられるようになる。
「迷惑メールの自動判定」などは、この方式の代表例です。
② 自分で傾向に気づく(教師なし学習)
正解ラベルなしで、データの山だけを渡す方式です。
利用者アンケートを1,000枚読み込んでいるうちに、「平日午前の健康目的層」「週末の家族連れ層」「夜間のサークル層」と、誰にも教わっていないのにグループが見えてくる。
あの感覚です。
③ 試行錯誤で上達する(強化学習)
やってみて、結果が良ければ「プラスの評価」、悪ければ「マイナスの評価」を受け取りながら、より良い行動を探していく方式です。
たとえば、新人スタッフに施設運営を模したシミュレーションゲームを何度もやってもらう。 利用者満足度が上がる行動を選べば得点、下がれば減点。 何百回も繰り返すうちに、高得点の行動パターンを自分で見つけ出していく——そんなイメージです。
囲碁や将棋のAIが人間の名人を超えたのは、主にこの「膨大な試行錯誤」の力です。
——お気づきでしょうか。
3つとも、現場で人が育つ仕組みとよく似ているんです。 AIは魔法の箱ではなく、「学び方を工夫された、経験量がケタ違いの新人」だと思ってください。
深層学習——「見る目」を何層も重ねる
では、最近よく聞く**深層学習(ディープラーニング)**とは何か。
機械学習の一種で、人間の脳の神経回路から着想を得た「ニューラルネットワーク」という仕組みを、何層にも深く重ねたものです。 (脳を再現したものではなく、あくまでヒントにした設計です)
「層を重ねる」とはどういうことか。
田中さんが佐藤さんを見分けるプロセスを、あえて分解するとこうなります。
第1段階:輪郭や色をとらえる 第2段階:目・眼鏡・髪型などのパーツをとらえる 第3段階:パーツの組み合わせで「佐藤さんの顔」と分かる 第4段階:表情や時間帯まで合わせて「今日は予約変更だな」と読む
実際のAIの内部が、この4段階にきれいに分かれているわけではありません。あくまでイメージです。
ただ、「浅い層で単純な特徴を、深い層でより複雑な特徴や関係を捉える」という発想は、深層学習の本質をよく表しています。
画像の認識、音声の聞き取り、翻訳——ここ10年ほどでAIが急に実用的になった分野は、ほぼこの深層学習の成果です。
そして重要なのはここ。
ChatGPTなどの生成AIも、この深層学習の技術の上に成り立っています。
膨大な文章を「例」として学び、言葉のつながりのパターンを掴んだAIが、質問に対して「この流れなら、次に来るのはたぶんこの言葉」と予測を連ねて、文章を組み立てている。
(正確には「言葉」ではなく、言葉を細かく分けた「トークン」という単位ですが、ここでは「次の言葉」と考えて大丈夫です)
流暢に話しているように見えて、やっていることは超高速の「パターン予測の連続」なんです。
ここで注意:AIには「2つの顔」がある
読者のみなさんの中には、こう思った方がいるはずです。
「え、AIは検索じゃないの? でも、ChatGPTに調べものしてもらってるけど?」
いい質問です。ここが今日いちばん誤解しやすいところ。
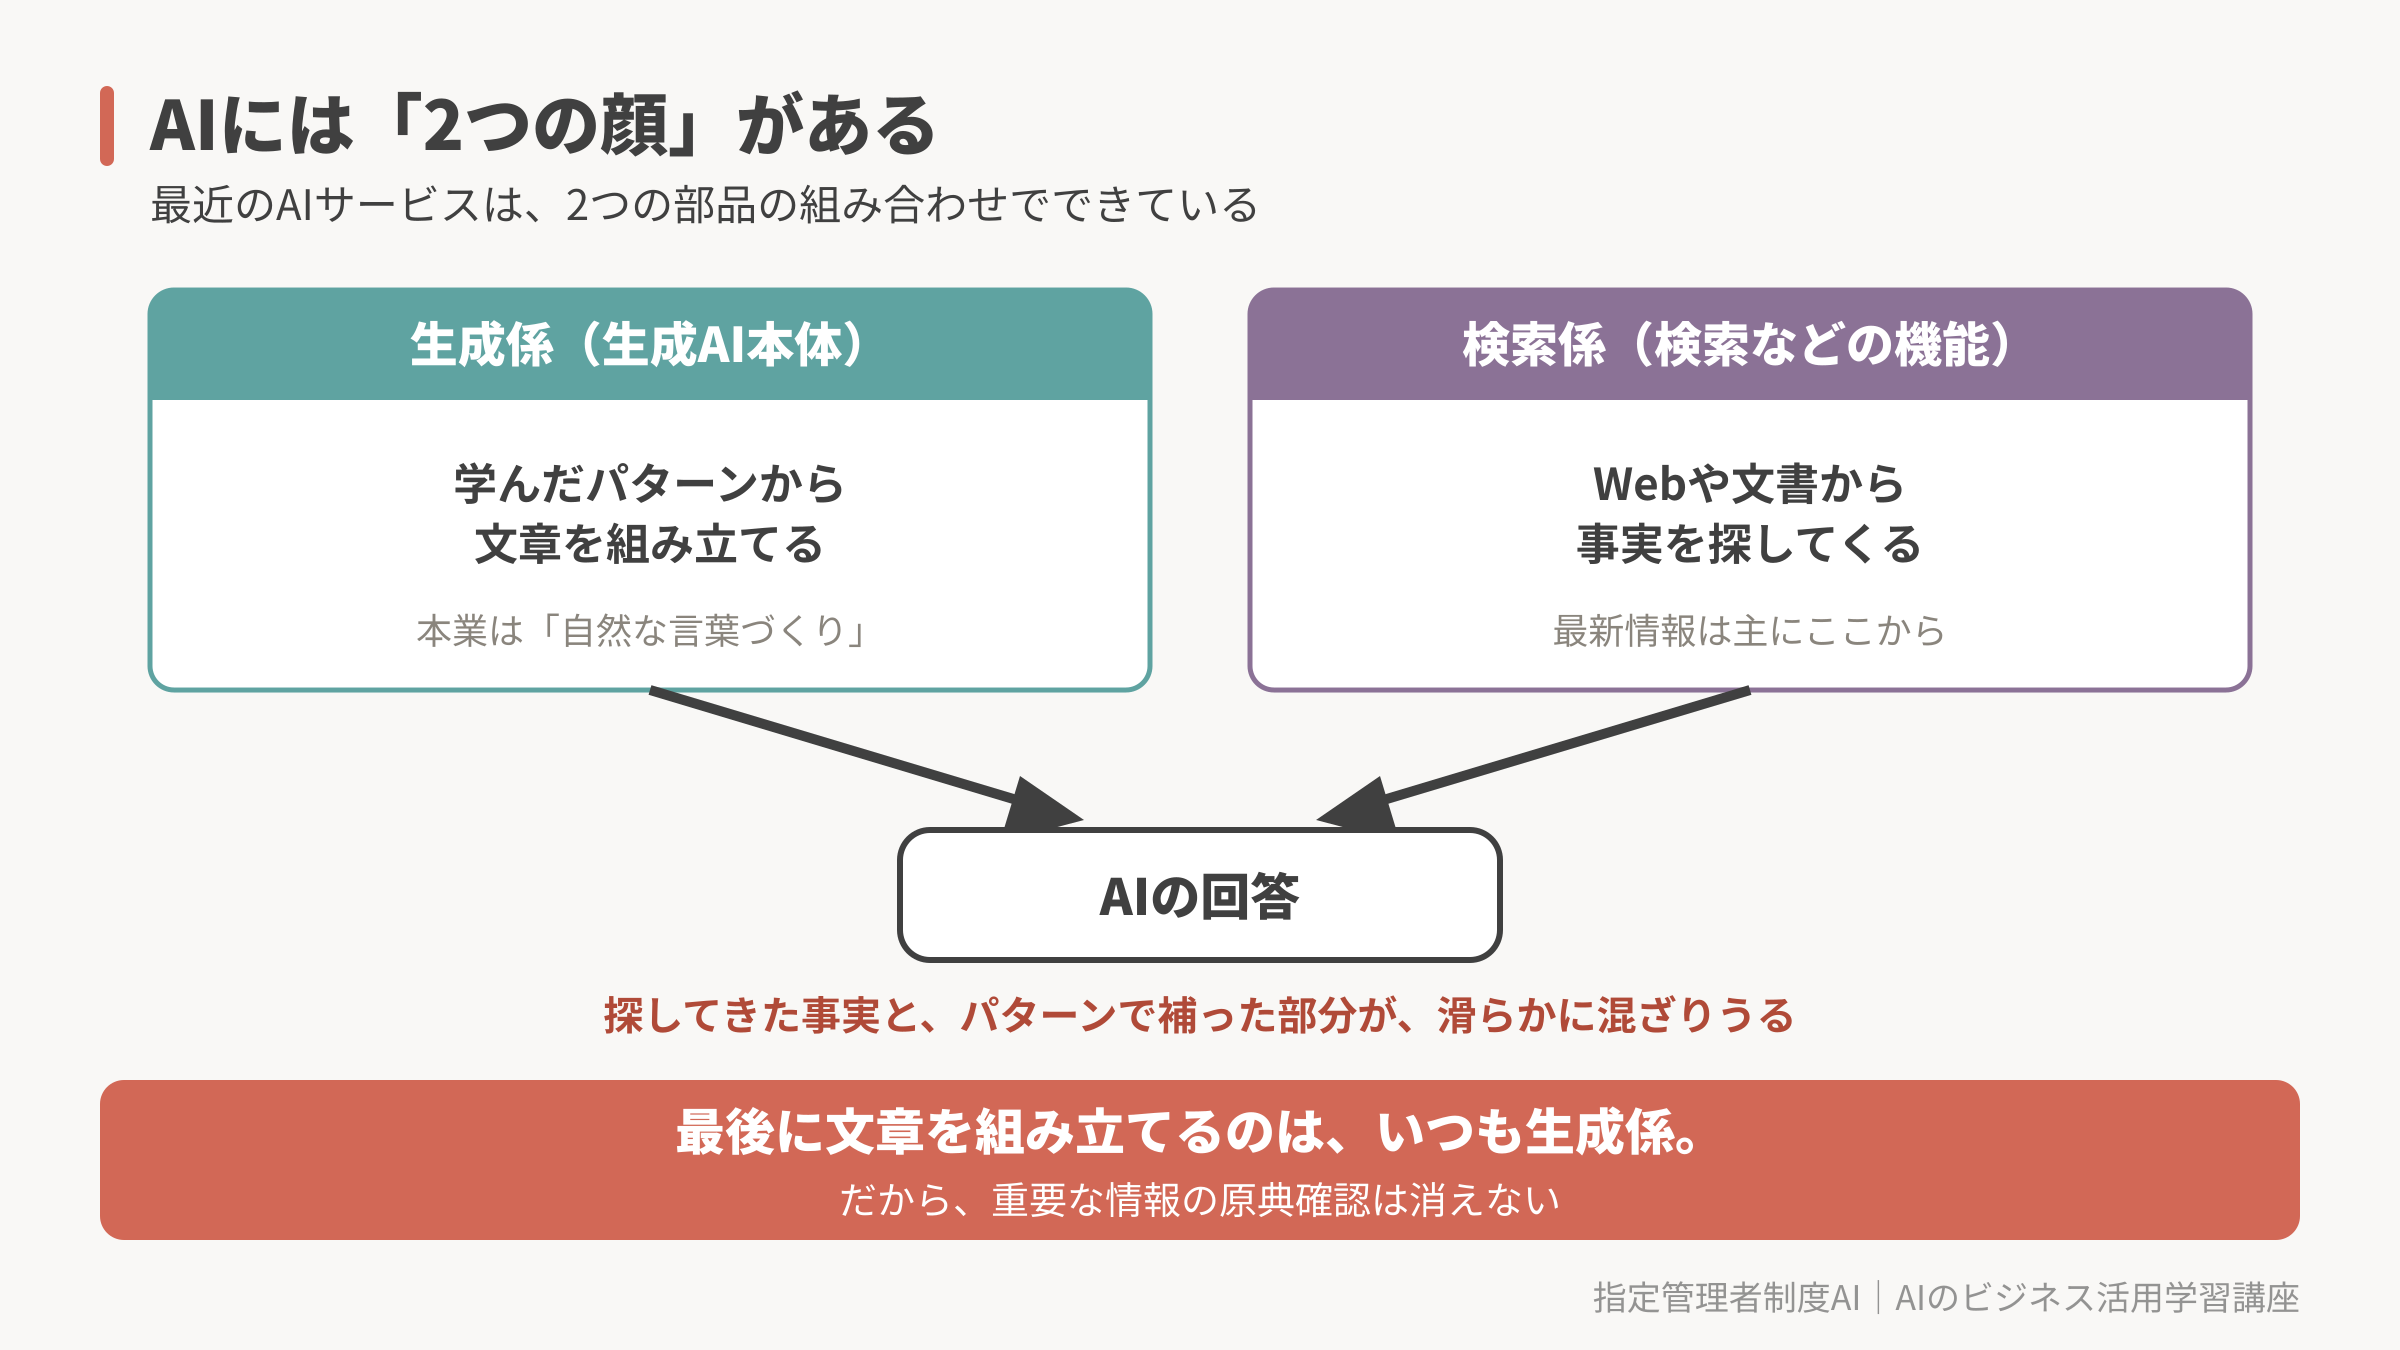
最近のAIサービスの多くは、2つの部品の組み合わせでできています。
① 生成AI本体——学んだパターンから文章を組み立てる係 ② 検索などの機能——Webや文書から事実を探してくる係
「AIに聞いたら最新情報が出てきた」というとき、それはAI本体の頭の中に最新情報が入っていたのではなく、検索係が外から取ってきた情報を、生成係が文章にまとめていることが多いのです。
役割分担を知っておくと、こう考えられるようになります。
検索機能を使った回答でも、最後に文章を組み立てているのは生成係。 つまり、探してきた事実と、パターンで補った部分が、滑らかに混ざりうる。
だから、どんなに便利になっても「重要な情報は原典で確認」が消えないわけです。
だから起こる、「もっともらしい間違い」——流暢さ≠正しさ
さて、ここまで来ると、連載で繰り返してきた注意の正体が見えてきます。
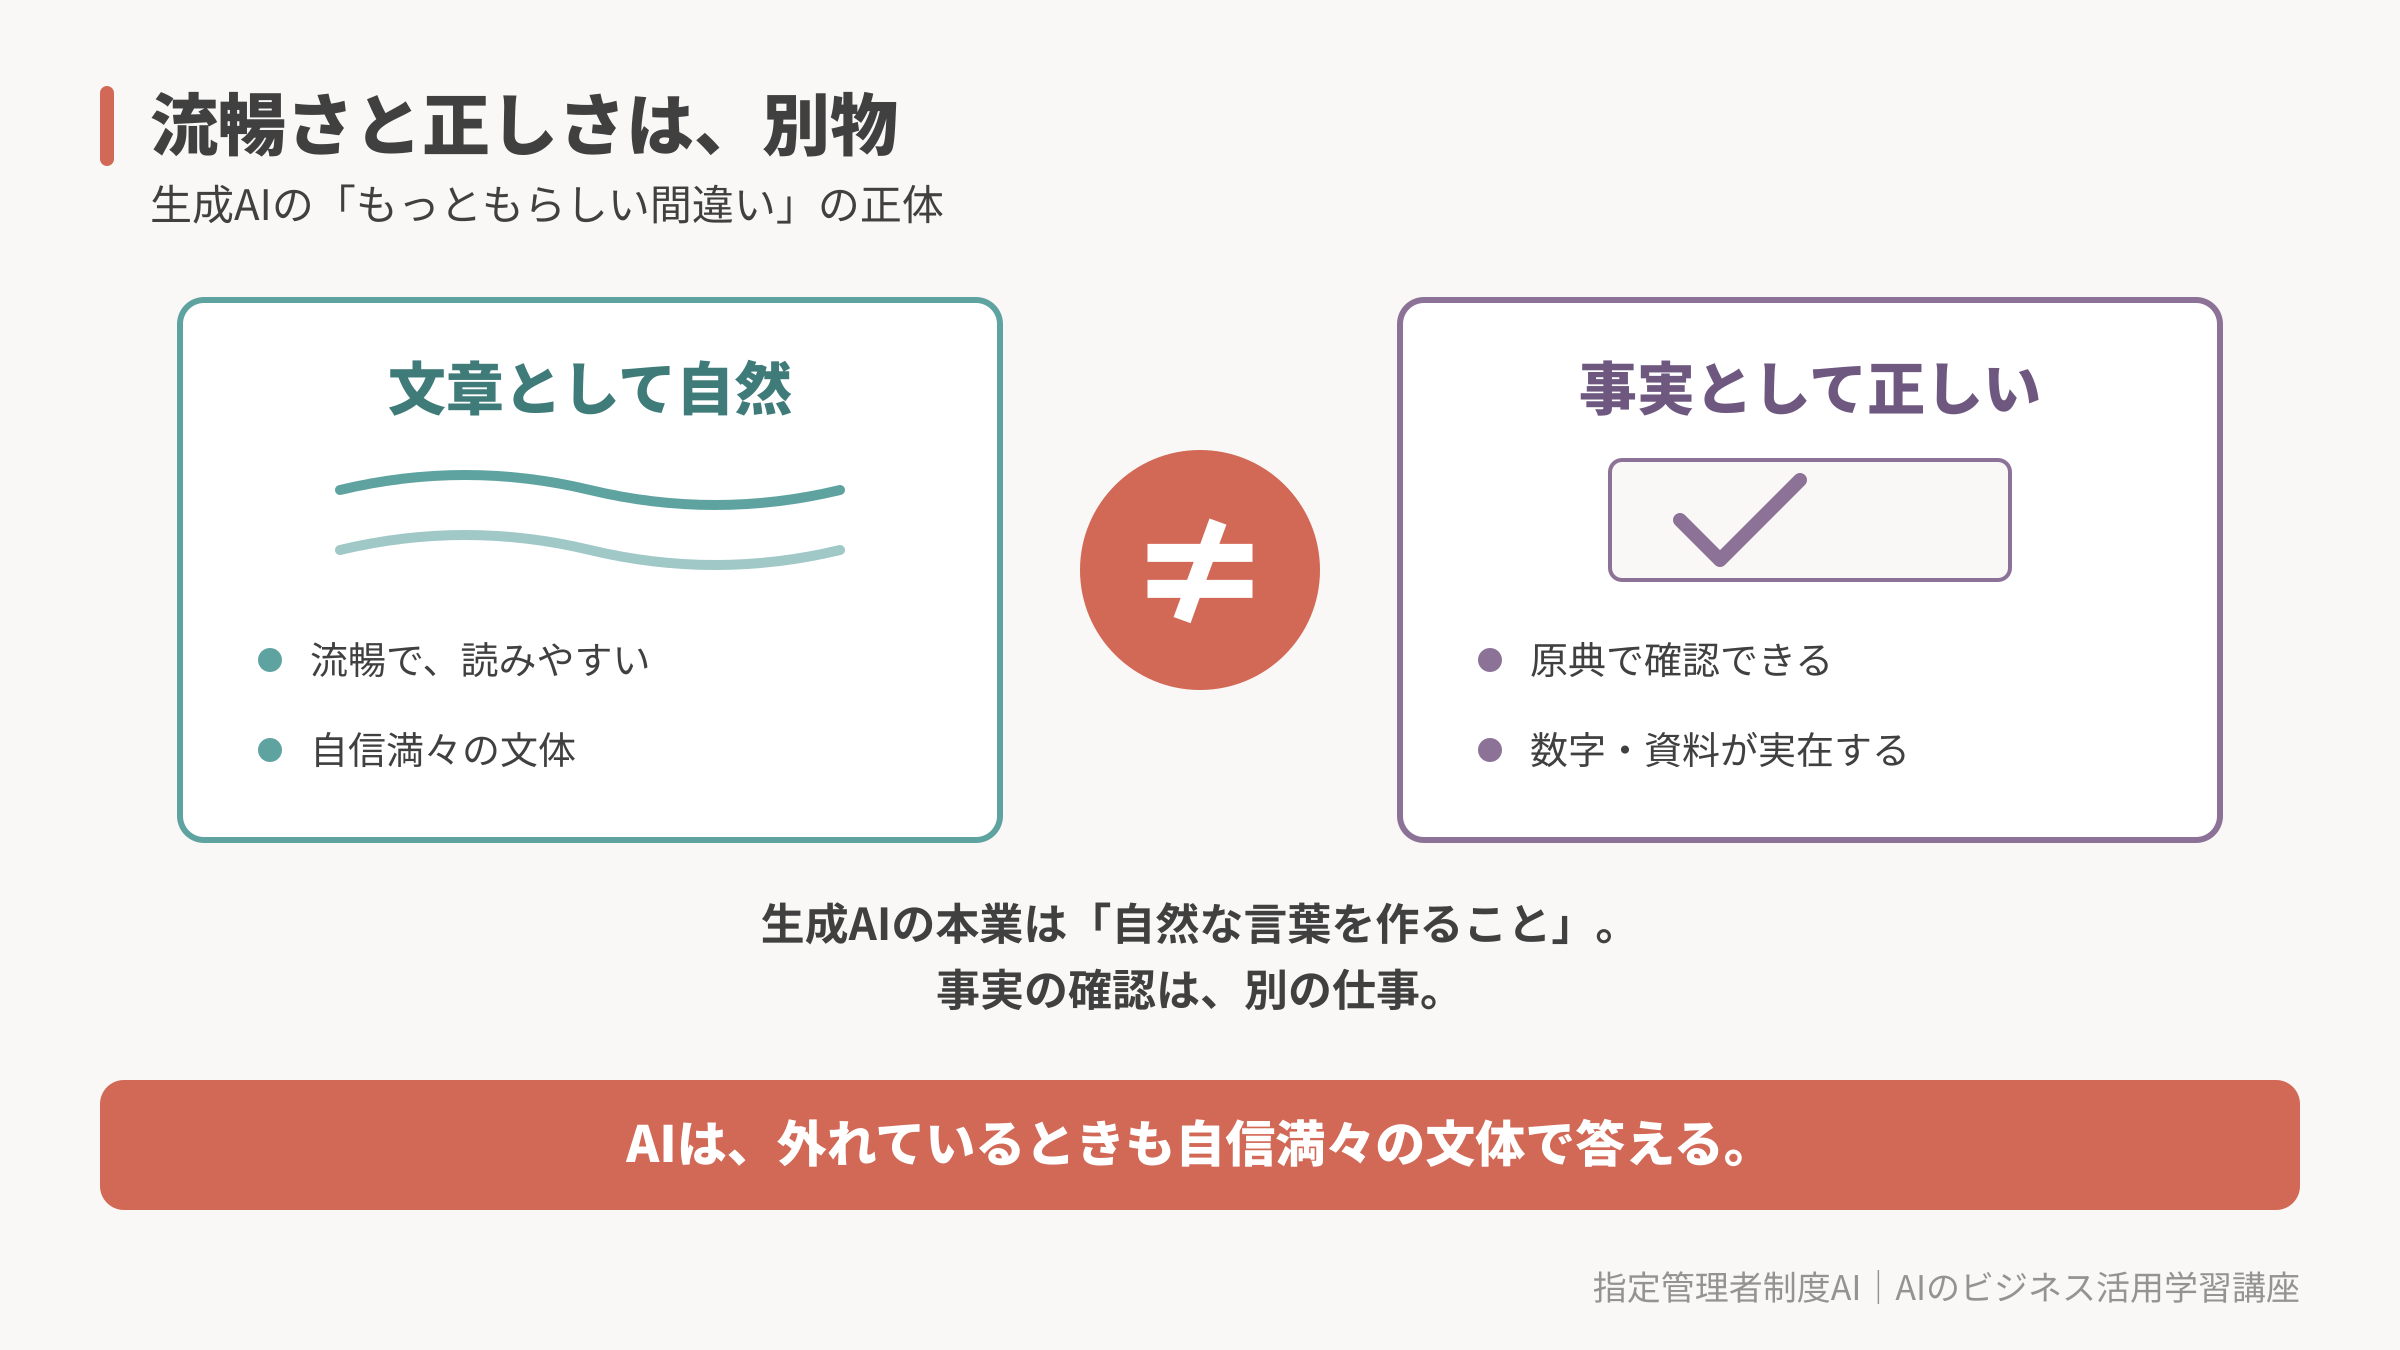
生成AIにとって、「次にもっとも自然な言葉を作ること」と「その内容が現実世界で事実かを確認すること」は、同じ仕事ではありません。
AIの本業は前者です。
だから——
知らないことを聞かれても、それらしく埋めてしまう。
存在しない条例名。 実在しない統計数値。 ありそうで、ない資料名。
AIに悪意はありません。 パターン的に自然な言葉を置いただけです。
でも読み手には、本当の情報と区別がつかない。 これが、第1回からお伝えしてきた「もっともらしい間違い」の仕組み上の理由です。
一言でまとめます。
文章として自然であることと、事実として正しいことは、別物。
田中さんだって、15年の経験からの「読み」が外れる日はあります。 違うのは、田中さんは「今日は自信ないな」という顔をしてくれること。
AIは、外れているときも自信満々の文体で答えます。 ここが一番の落とし穴です。
仕組みを知ると、6回分のルールが腑に落ちる
ここまでの仕組みを踏まえて、連載のルールを振り返ってみましょう。 全部、理由がつながります。
① 「根拠は原典で確認」(第5回)の理由
AIの本業は組み立てること。事実確認は別の仕事。 だから、根拠にできるのは原典で確認できた情報だけ、でしたよね。
② 「日時・料金を創作させない」(第6回)の理由
パターンで埋める機械は、空欄があると「それらしい数字」を置きにいきます。 だから、事実情報は1文字も変えさせない指示が必要でした。
③ 「依頼の4点セット」(第2回)が効く理由
AIは、入力された文脈を手がかりに回答を生成します。 ゴール・背景・お願い・仕上がりが具体的なほど、意図に沿った答えを組み立てやすくなる。 気分の問題ではなく、仕組みの必然です。
④ 「AIが整理し、人間が判断する」(第5・6回)の理由
大量の例からパターンを見つけるのは、機械学習の本業中の本業。 一方、「うちの施設にとってどうか」という判断は、AIが学んだ例のどこにも入っていません。 現場の文脈を持っているのは、あなただけです。
そして——施設の記録が、AI時代の「知識資産」になる
最後に、この連載の未来につながる話をひとつ。
AIの性能が「学ぶ例の質と量」で決まることは、ここまで見てきたとおりです。
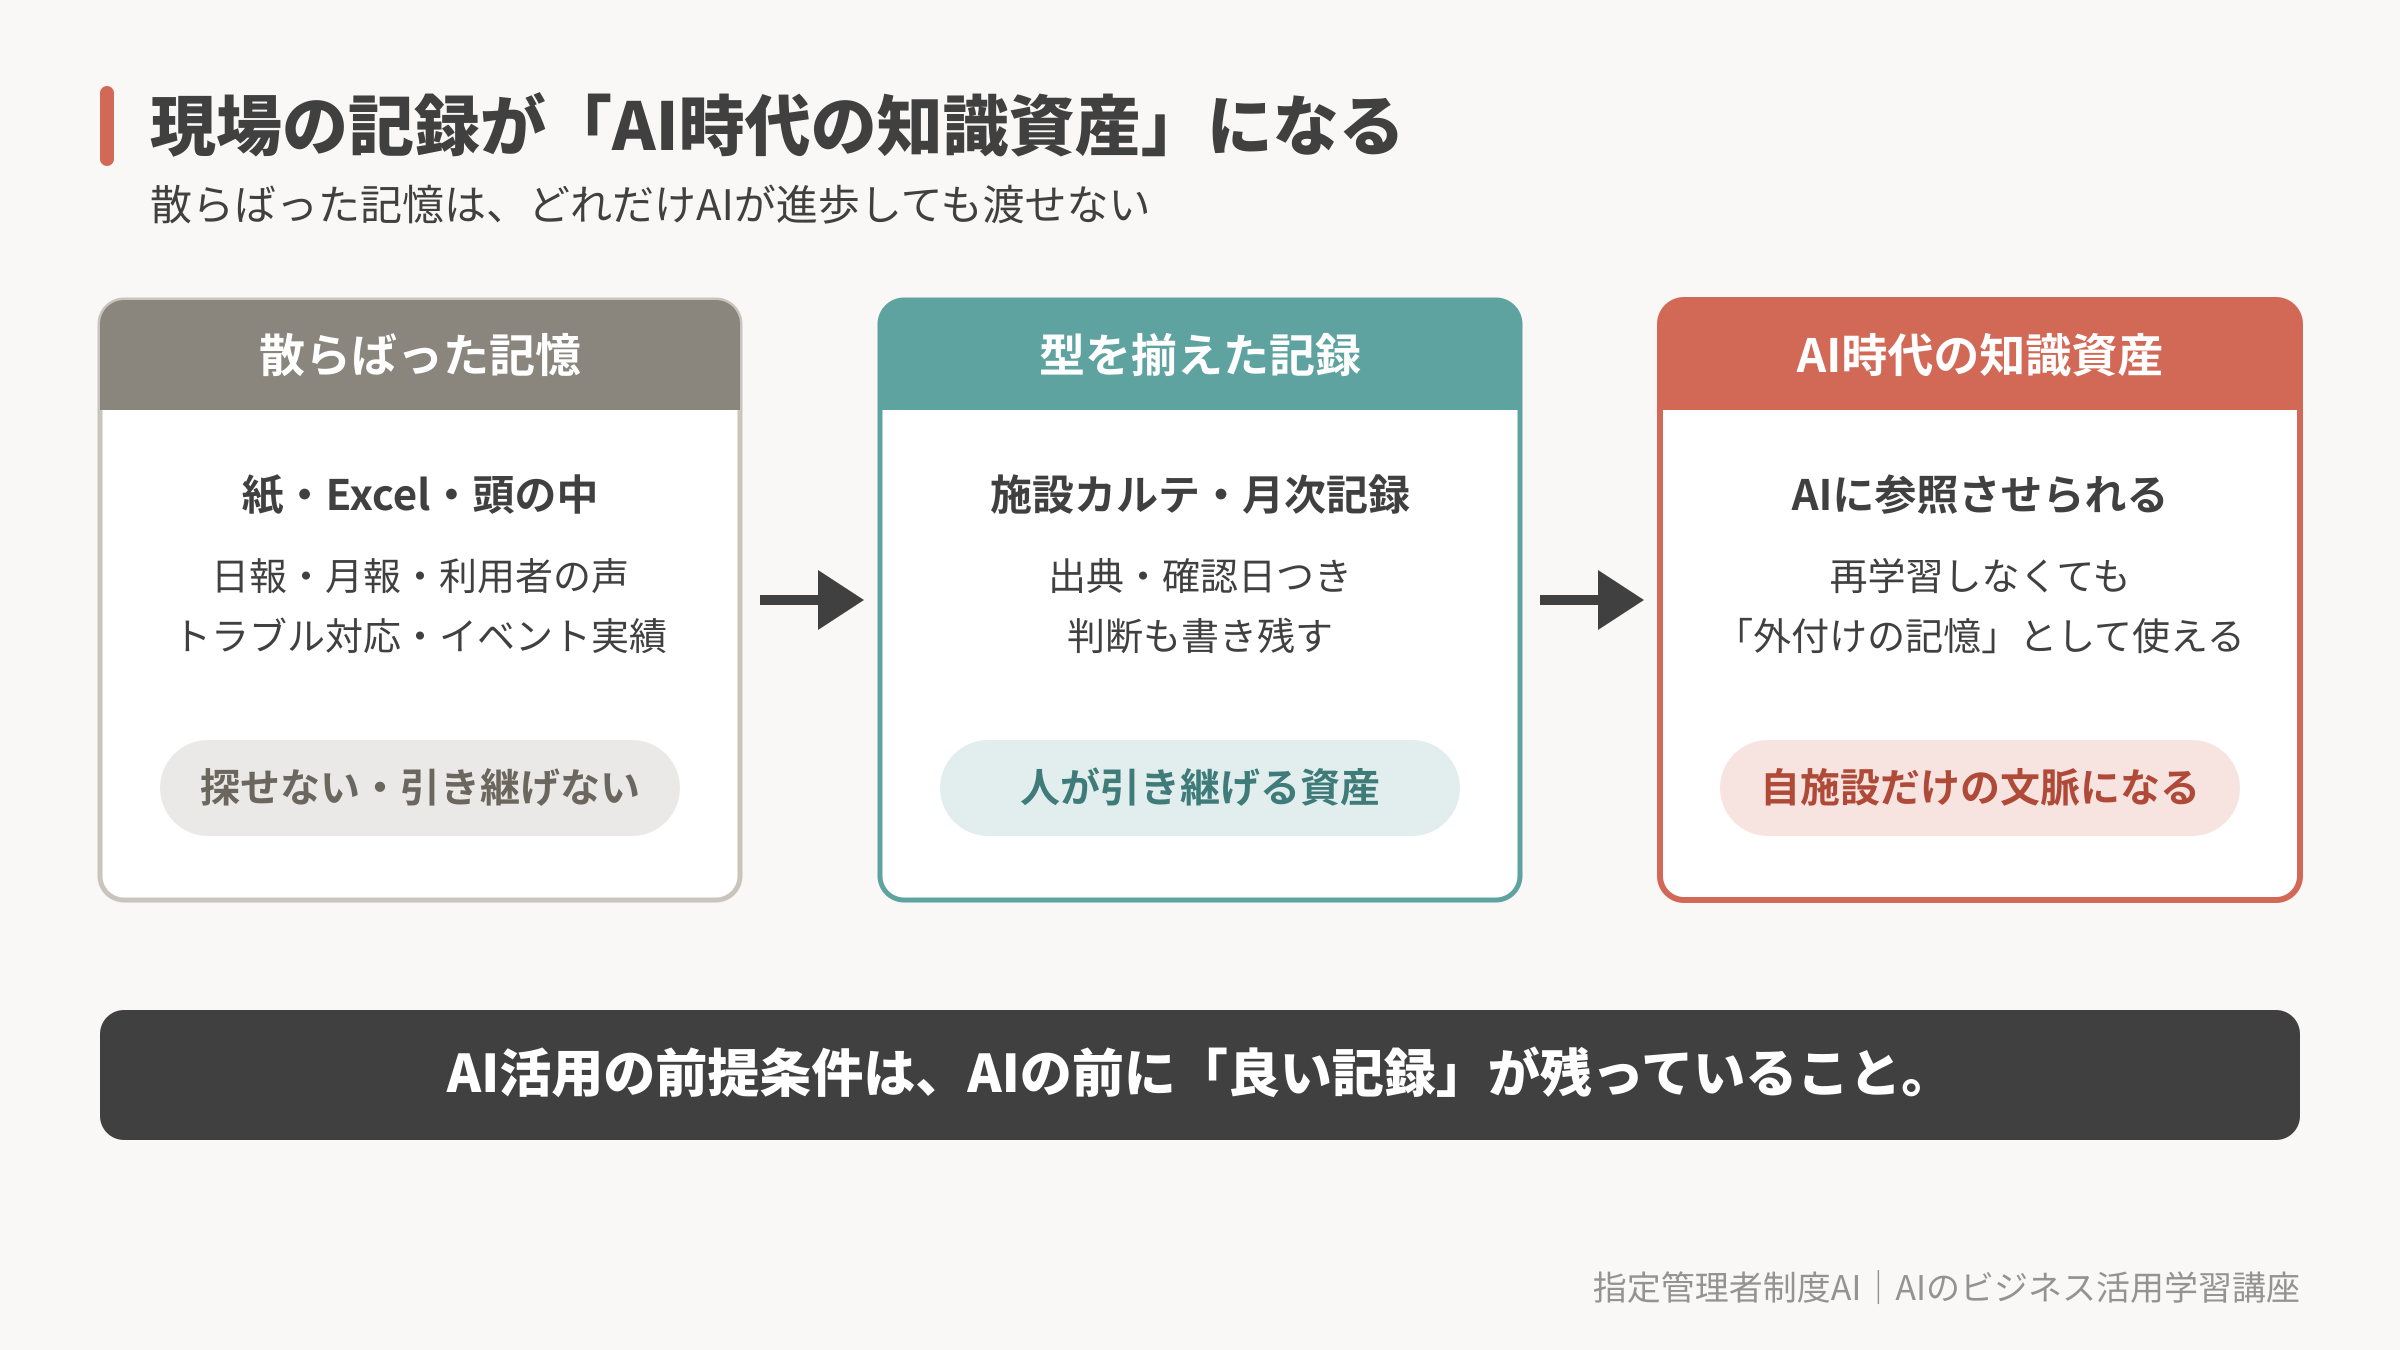
そして最近は、AIを再学習させなくても、手元の記録を検索・参照させながら回答させる仕組みが広がっています。 自社の文書を「外付けの記憶」としてAIに読ませるイメージです。
つまり、こういうことです。
第5回の施設カルテ。 第6回の発信の記録。 日報、月報、利用者の声、トラブル対応、イベント実績。
型を揃えて残してきたこれらの記録は、人間の引き継ぎ資産であると同時に、将来、AIに自施設の文脈を参照させるための知識資産にもなります。
逆に言えば——紙とExcelと職員の頭の中に散らばったままの記憶は、どれだけAIが進歩しても、AIには渡せません。
AI活用の前提条件は、AIの前に「良い記録が残っていること」なんです。
AIを学ぶことと同じくらい、現場の仕事をきちんと記録して残すこと。 この連載が毎回「記録して資産にする」と言い続けてきた理由は、実はここまでつながっています。
ミニ体験:「生成には揺らぎがある」を5分で体感する
最後に、今日の話を体で理解できる小さな実験をひとつ。
お使いのAI(ChatGPTなど)で、新しいチャットを2〜3回立ち上げて、まったく同じ質問をしてみてください。
公共施設の利用者満足度を高める工夫を、3つ挙げてください。
見比べると、選ばれる例や表現、順番が変わることがあります。 (サービスや設定によっては、似た回答になることもあります)
これは、AIの回答が「どこかにある唯一の完成原稿を取り出したもの」ではなく、その都度、文脈をもとに組み立てられたものだと感じるための小さな実験です。
この「揺らぎ」を一度体感しておくと、AIの答えを鵜呑みにしない感覚が、頭ではなく肌で身につきます。
まとめ
- AIは「調べて答える機械」ではなく、膨大な例からパターンを学び、答えを組み立てる機械
- 機械学習は「田中さん方式」——ルールではなく例から学ぶ。急速な進歩は「データ・計算能力・学習方法」の3つが揃ったから
- 学び方は3つ。答え合わせ付き・自分で気づく・試行錯誤——現場のOJTとよく似ている
- 深層学習は、脳の神経回路から着想を得た仕組みを何層も重ねたもの。生成AIもこの技術の上にある
- 最近のAIサービスは「生成する係」と「探してくる係」の組み合わせ。検索機能があっても、最後に文章を組み立てるのは生成係
- だから、文章として自然≠事実として正しい。原典確認・数字の創作禁止・4点セットは、すべてこの仕組みへの対策だった
- そして、型の揃った現場の記録は、AI時代の知識資産になる
第1回で、AIを「経験ゼロだが知識豊富な新人」に例えました。
今回は、その新人がどうやって「それらしい答え」を作っているのか、裏側を少しだけ覗いてみました。
仕組みが分かると、AIの見え方が変わります。
流暢に答えたからといって、正しいとは限らない。 逆に、間違えることがあるからといって、使えないわけでもない。
AIが得意なことをAIに任せ、現場の文脈と、最後の確認・判断を人が持つ。
それが、この講座で第1回からお伝えしてきた、AIとの付き合い方です。
そして、もうひとつ。
これからAI活用が進むほど、価値を持つのはAIそのものだけではありません。
あなたの施設にしかない「現場の記憶」が、AI時代の知識資産になります。
次にAIを開いたとき、少しだけ田中さんを思い出してください。
「この人、いま経験からそれらしい答えを出しているんだな」と。
そう思えるだけで、AIとの距離感は、きっとちょうどよくなります。
【関連リンク】
- 【指定管理者・PFI事業者向け】AIとは何か?現場担当者がゼロから理解する超入門ガイド
- 【指定管理者・PFI事業者向け】プロンプトとは?AIへの上手な頼み方を「仕事の依頼」で理解する超入門
- 【指定管理者・PFI事業者向け】AIで文書作成はどう変わる?「書く前の設計」で差がつくビジネス文書超入門
- 【編集長ヤマザキのAI活用講座】提案書は「書く時間」より「読み直す時間」で決まる。ヤマザキ式・読み直し3回ルール
- 【指定管理者・PFI事業者向け】AIで情報収集はどう変わる?「調べて終わり」にしない情報の仕込み超入門
- 【指定管理者・PFI事業者向け】AIでSNS発信はどう変わる?「告知して終わり」にしない施設広報超入門
\仕組みを知ったら、次は実践です/ 指定管理者制度AIでは、全国約1,700市区町村の指定管理者募集情報を毎日自動収集。指定管理・PFIに特化したAI活用ノウハウ記事も配信中です。 月額10,000円/年間120,000円(請求書払い・年間契約対応) 👉 Proプランの詳細はこちら
指定管理者制度に携わる皆様の業務効率化と採択率向上をサポートする記事をお届けしています。
ヤマザキは2004年から大学で指定管理者制度を研究し、
2010年からの10年間は、指定管理/PFI/PPPのコンペや運営現場の最前線に立ち続けてきました。
その後はスタートアップとの協業や出資、ハッカソンも数多く主催。「現場」と「未来」双方の知見を活かした情報発信を行っています。
その経験をもとにした本サービス「指定管理者制度AI」では、実際にAIを活用した提案書・企画書作成サービスを展開。 豊富な採択事例データベースと高度な自然言語処理技術により、要点整理から文書構成の最適化まで包括的にサポートします。
自治体要件の読み取り、競合分析、予算計画の策定など、指定管理者応募に必要な業務を効率化し、 質の高い提案資料を短時間で作成できる専門AIツールを提供しています。